メディア潜在変数のエンコード (Encode Media Latent)
画像または動画に対してパイプラインの VAE エンコーダーを実行し、Image-to-Image / Video-to-Video フローのデノイズ入力として使用できる潜在変数を生成します。
カテゴリ: ModularDiffusion/Encode\Decode
概要 (TL;DR)
- 入力スロットは 動的 (Dynamic) です。画像パイプラインでは
image、動画パイプライン(LTX, LTX2, WAN など)ではinput_videoに自動的に切り替わります。 - 生成される潜在変数は正規化およびアンパックされており、Create Noise Latents と形状互換性があるため、潜在変数の算術演算ノードやマスク合成ノードを直接適用できます。
- 従来の Image-to-Image ワークフローを実現するには、下流の Generate Media Latents ノードで
add_noise=Trueを有効にします。付加されるノイズ量はそのノードのstart_stepパラメータで制御されます(強度 (strength) = 1 − (start_step / num_inference_steps))。例えばnum_inference_steps=20の場合:start_step=0→ フルノイズ(強度 1.0)— 元画像は無視され、Text-to-Image と同様に動作します。start_step=10→ 半分のノイズ(強度 0.5)— 元画像と生成内容が均等にブレンドされます。start_step=18→ わずかなノイズ(強度 0.1)— 元画像に極めて近い結果を保持します。
ワークフローにおける一般的な配置 (Typical workflow position)
Load Image → [Encode Media Latent] → Generate Media Latents → Decode Media Latent
ノードプレビュー (Node preview)
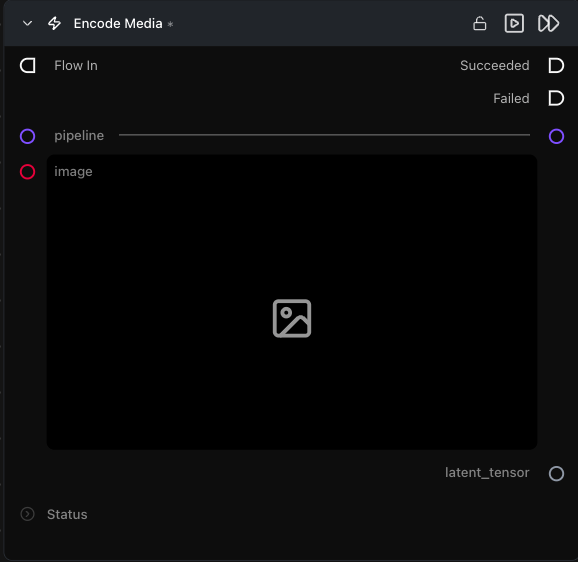
入力 (Inputs)
| 名前 | 型 | 必須 | 備考 |
|---|---|---|---|
pipeline |
Pipeline Config |
はい | 入力スロットを image または input_video のどちらにするかを決定します。 |
image |
ImageArtifact / ImageUrlArtifact |
画像パイプライン時 | 元画像。 |
input_video |
VideoArtifact / VideoUrlArtifact |
動画パイプライン時 | 元動画。 |
出力 (Outputs)
| 名前 | 型 | 備考 |
|---|---|---|
latent_tensor |
LatentArtifact |
パイプラインの標準潜在空間にエンコードされた潜在変数。 |
ヒントと注意点 (Tips & pitfalls)
- 入力スロットは接続されたパイプラインに適応します: 静止画パイプライン(Flux, SD3 など)では
image入力が、動画パイプライン(LTX, LTX2, WAN など)ではinput_video入力が表示されます。パイプラインの種類を切り替えるとスロットが置き換わるため、接続をやり直してください。 - ゼロからの Text-to-Image / Text-to-Video には Create Noise Latents を使用してください: 本ノードは既存の画像や動画を潜在空間に変換して Image-to-Image や Video-to-Video を行うためのものであり、ゼロからの生成には適していません。
関連項目 (See also)
- Encode Masked Media Latent — インペイント用バリアント。
- Decode Media Latent — 逆の操作(潜在変数から画像/動画へのデコード)。
- ワークフローテンプレート:
workflows/templates/Image2Image.py。