モジュラーディフュージョン パイプラインビルダー (Modular Diffusion Pipeline Builder)
🧨 Diffusers パイプラインを 1 回ロードしてキャッシュし、ワークフロー内のすべてのノードで再利用できるようにします。
カテゴリ: ModularDiffusion/Pipeline
概要 (TL;DR)
- 1 回ビルドして何度も生成: ワークフローの最初に本ノードを配置し、モデルの重みを必要とする他のすべての Modular Diffusion ノード(Generate Media Latent, VAE Encode/Decode, Create Noise など)に
pipeline出力を接続します。 - 最初に
providerを選択: 他のすべてのパラメータ(モデルリポジトリ、ランタイム制御ノブ)は、選択したプロバイダーに基づいて動的に再生成されます。 - パイプラインは設定ハッシュによってキャッシュ: ロード時パラメータ(モデルリポジトリ、量子化、LoRA)を変更すると再構築と再キャッシュが行われますが、ランタイムパラメータ(プロンプト、ステップ数など)の変更では再構築は発生しません。
- 出力型:
Pipeline Config。
ワークフローにおける一般的な配置 (Typical workflow position)
[Pipeline Builder] → Create Noise Latents → Generate Media Latents → Decode Media Latent
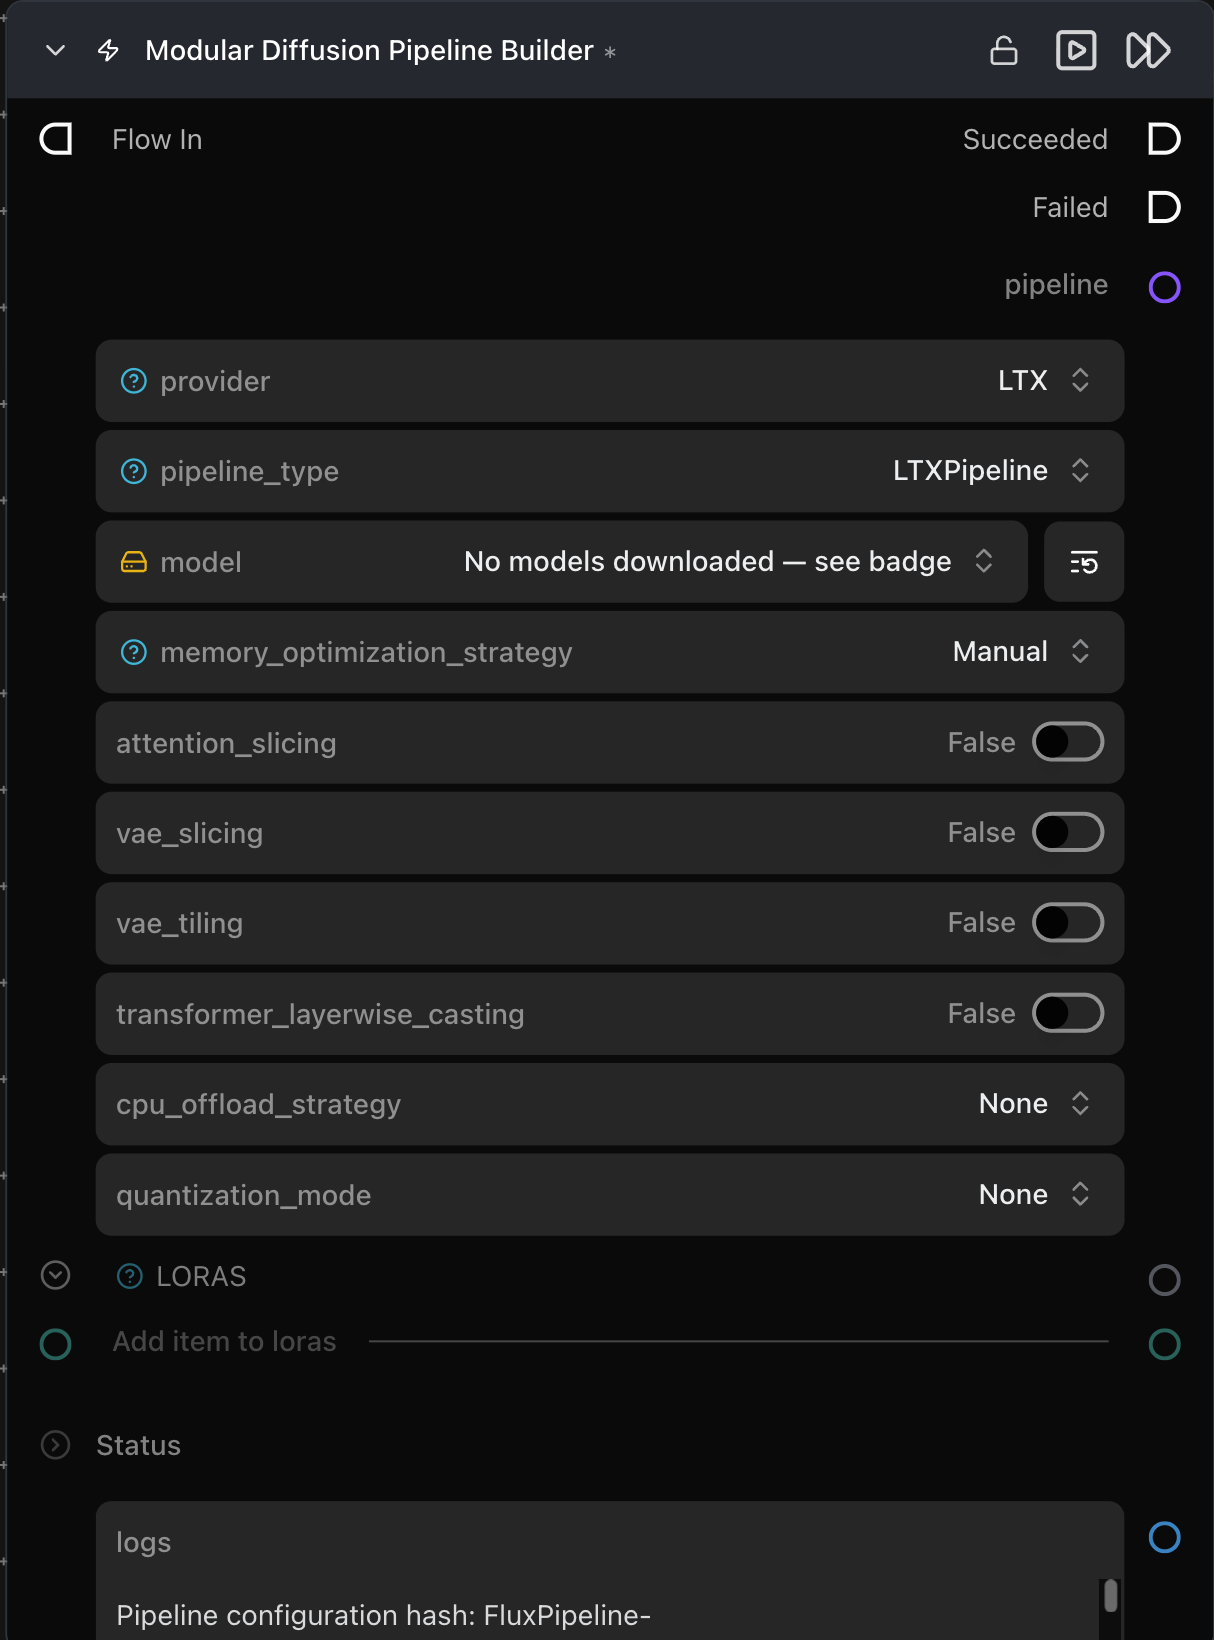
ノードプレビュー (Node preview)
入力 (Inputs)
| 名前 | 型 | 必須 | 備考 |
|---|---|---|---|
loras |
loras |
いいえ | 1 つ以上の Load LoRA ノードを接続。接続順にスタックされます。 |
出力 (Outputs)
| 名前 | 型 | 備考 |
|---|---|---|
pipeline |
Pipeline Config |
キャッシュされたパイプラインアーティファクト。pipeline 入力を持つ各ノードへ供給します。 |
logs |
str |
解決された設定ハッシュを含むビルドログ。 |
パラメータ一覧 (Parameters)
パイプライン選択 (Pipeline selection) (動的 — provider 変更時に再生成)
| 名前 | 型 | 備考 |
|---|---|---|
provider |
選択肢 | Flux, Flux2, Stable Diffusion, Stable Diffusion 3, Qwen, Z-Image, HunyuanVideo 1.5, LTX, LTX2, WAN。これを変更すると以下のすべてのパラメータが切り替わります。 |
pipeline_type |
選択肢 | プロバイダーごとのパイプラインクラス(例: FluxPipeline, WanImageToVideoPipeline)。パイプラインの機能を決定します。 |
<model repo> |
HF リポジトリ選択 | Hugging Face リポジトリ ID。Diffusers 形式のみ対応(単一ファイルの .safetensors チェックポイントは直接読み込めません)。 |
メモリ最適化 (Memory optimization)
| 名前 | 型 | デフォルト | 備考 |
|---|---|---|---|
memory_optimization_strategy |
選択肢 | Manual |
Automatic にすると以下の個別トグルが非表示となり、モデルに応じた適切なデフォルト値が使用されます。 |
attention_slicing |
bool | False |
わずかな推論速度低下で効果的にメモリを節約します。 |
vae_slicing |
bool | False |
潜在変数をバッチサイズ 1 でデコードします。大きなバッチサイズを扱う際に効果的です。 |
transformer_layerwise_casting |
bool | False |
Transformer を低精度で保持し、計算時にレイヤーごとにアップキャストします。 |
cpu_offload_strategy |
選択肢 | None |
Model(サブモジュール全体)または Sequential(レイヤー単位)— アイドル状態の重みを CPU に移動して VRAM を解放します(推論速度は低下します)。 |
quantization_mode |
選択肢 | None |
fp8 / int8 / int4(optimum-quanto / bitsandbytes 経由)。多少の画質低下と引き換えに Transformer の重みを大幅に縮小します。 |
必要なオプションのみを有効にしてください。いずれの設定も速度とメモリのトレードオフとなります。
ヒントと注意点 (Tips & pitfalls)
- エンジン再起動後のパイプラインキャッシュ: キャッシュはプロセス内メモリにのみ存在するため、エンジン再起動後の初回実行時に自動的に再解決されます。
- ロード時の VRAM 不足 (Out of VRAM): モデルの重みが GPU の利用可能メモリを超えています。効果の大きい順に以下を試してください:
quantization_modeをint8またはint4に設定する、cpu_offload_strategyをModelに設定する、またはvae_slicingを有効にする。 - LoRA が適用されない場合: (1) 選択した
pipeline_typeと同じモデルアーキテクチャ向けに学習された LoRA か確認してください(Flux LoRA は WAN パイプラインでは動作しません)。(2) Load LoRA ノードが本ノードのloras入力に正しく配線されているか確認してください。 - 他のパラメータを設定する前に
providerを決定してください:providerを変更すると、新しいモデルに合わせてすべてのパラメータが再生成されます。
関連項目 (See also)
- Configure ControlNet · ControlNet Pipeline — 構築したパイプラインに ControlNet を追加。
- Load LoRA — このビルダーに LoRA をアタッチ。
- Generate Media Latents —
pipeline出力を消費する最も一般的なノード。